Large Language Models (LLM) patria k najvýkonnejším technológiám umelej inteligencie. Dokážu porozumieť textu, generovať obsah, pracovať s obrovským množstvom dát a učiť sa z kontextu podobne ako človek. LLM sa stali súčasťou nástrojov, ktoré používame denne – od vyhľadávania a chatbotov až po analýzy, automatizáciu či zákaznícke služby. Prečítaj si, ako fungujú, aké problémy riešia a kde v praxi majú najväčší prínos.
Large Language Model (LLM) je typ umelej inteligencie navrhnutý na prácu s prirodzeným jazykom. Dokáže porozumieť textu, analyzovať ho a generovať nové odpovede spôsobom, ktorý pôsobí prirodzene a zrozumiteľne pre človeka. LLM patrí do oblasti strojového učenia (machine learning) a predstavuje jednu z najpokročilejších foriem jazykovej umelej inteligencie.
V praxi sa Large Language Model využíva na široké spektrum úloh. Dokáže odpovedať na otázky, sumarizovať texty, prekladať medzi jazykmi, analyzovať dokumenty, generovať obsah alebo pomáhať pri automatizácii procesov vo firmách.
Medzi najznámejšie Large Language Modely patria ChatGPT, Claude alebo Gemini, ktoré sa dnes využívajú v podnikových nástrojoch, vzdelávaní, zdravotníctve aj v bežných aplikáciách, s ktorými sa používatelia stretávajú každý deň.
Ešte pred vznikom Large Language Modelov (LLM) existovali jednoduchšie jazykové modely, ktoré dokázali pracovať len s obmedzeným kontextom. Patria sem napríklad n-gramové modely, ktoré vedeli predpovedať ďalšie slovo na základe niekoľkých predchádzajúcich slov v texte. Problém spočíval v tom, že tieto modely mali zásadné obmedzenia – nerozumeli významu viet a nedokázali zachytiť širšie súvislosti. Ich presnosť bola preto pomerne nízka.
Najväčší zlom prišiel s nástupom neurónových sietí, najmä s transformátorovou architektúrou, ktorá umožňuje spracovať celý text naraz a zamerať sa na jeho najdôležitejšie časti.
Práve vďaka transformátorovej architektúre dnes existujú modely ako GPT (OpenAI) či Gemini (Google), ktoré disponujú miliardami parametrov a dokážu pracovať s kontextom na úrovni celého rozhovoru.
Svoj názov nezískal LLM len preto, že má veľké množstvo schopností, ale aj preto, že disponuje nespočetným množstvom dát a parametrov, ktoré dokáže efektívne využívať. Znamená to, že vie generovať text pôsobiaci prirodzene a súvislo.
Každý veľký jazykový model pozostáva z tzv. parametrov, teda číselných hodnôt. Ich počet ovplyvňuje, aké komplexné vzťahy dokáže LLM rozpoznať a ako presne vie predpovedať ďalšie slovo či vetu. Platí, že čím viac parametrov model má, tým je jeho výstup plynulejší a presvedčivejší.
Aktuálne modely, s ktorými sa bežne stretávame, majú stovky miliárd až jednotky biliónov parametrov. Okrem samotných parametrov majú LLM k dispozícii aj terabajty textových dát z rôznych oblastí, na základe ktorých sa priebežne zlepšujú a dokážu:
LLM sú súčasťou širokej oblasti známej ako umelá inteligencia (AI). Presnejšie však patria do strojového učenia (machine learning) a hlbokého učenia (deep learning). Pre lepší prehľad si pozri základné rozdiely medzi jednotlivými pojmami:
Fungovanie Large Language Modelu je založené na spracovaní textu ako sekvencie pravdepodobností. Model nepracuje s porozumením v ľudskom zmysle slova, ale s matematickým vyhodnocovaním vzťahov medzi slovami v kontexte celého textu. Základom tohto procesu je transformátorová architektúra, tokenizácia a predikcia ďalšieho tokenu.
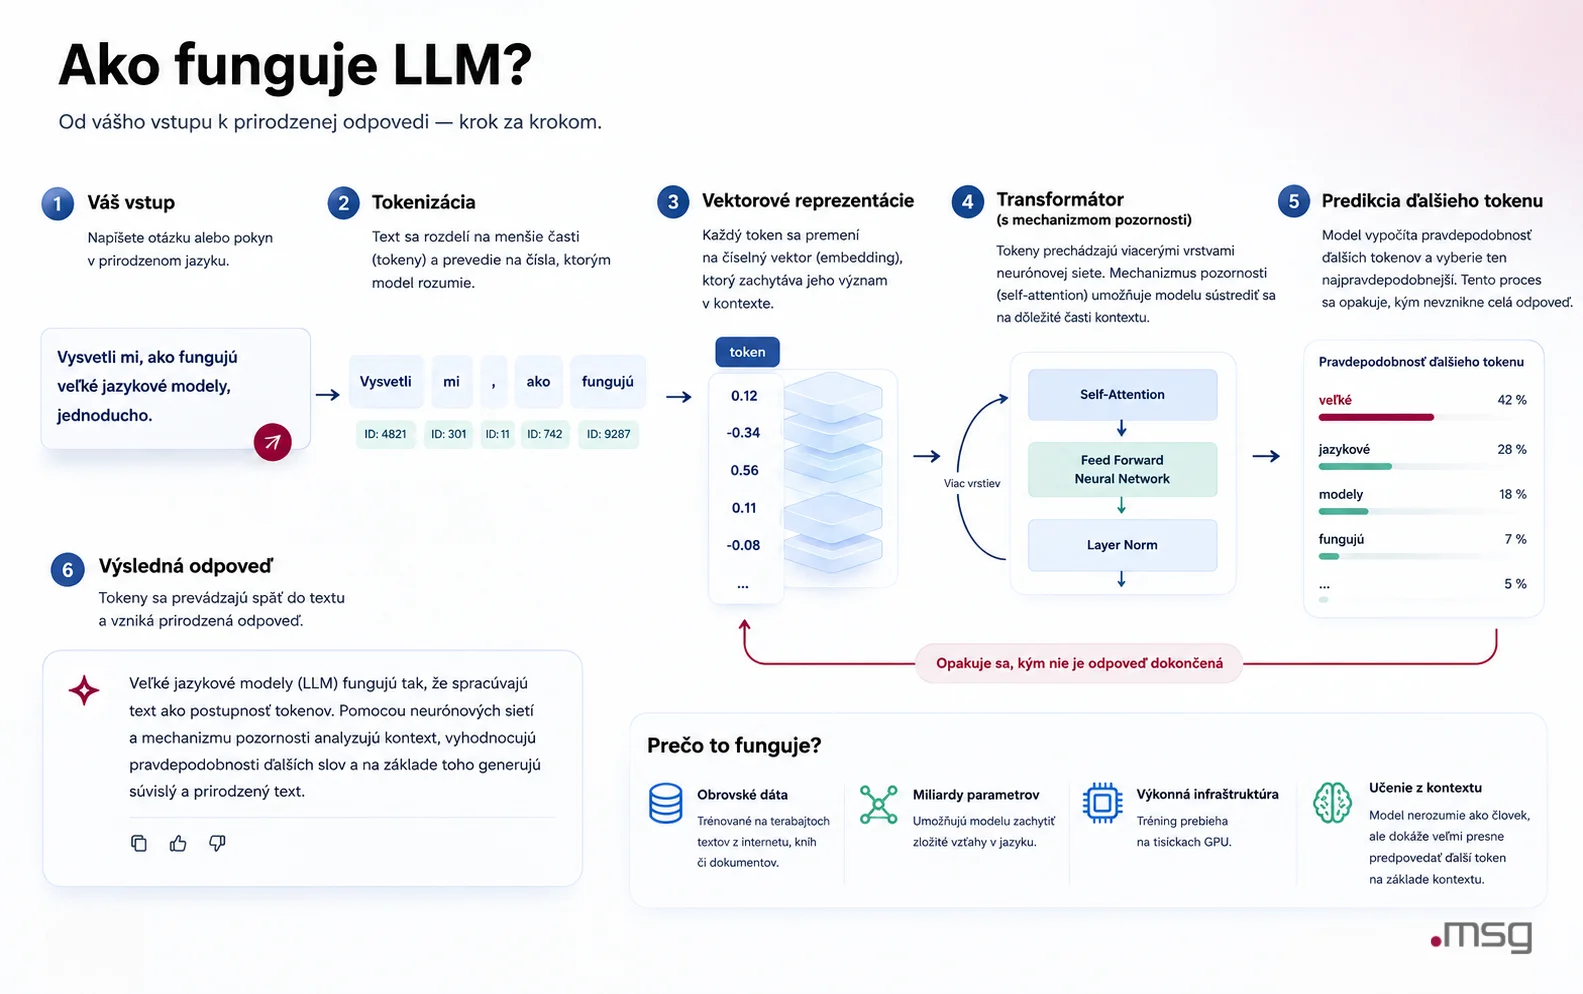
Transformátorová architektúra bola po prvýkrát predstavená v roku 2017 a okamžite začala meniť oblasť umelej inteligencie. Pred jej vznikom modely spracúvali text spravidla sekvenčne – po jednom slove alebo vete. V praxi to znamenalo, že ak sa na začiatku textu objavila dôležitá informácia, model si ju na konci už nepamätal. A to bol zásadný problém.
Transformátor však priniesol efektívne riešenie – mechanizmus pozornosti (attention), konkrétne self-attention. Vďaka nemu sa model dokáže sústrediť na relevantné časti textu bez ohľadu na to, kde sa nachádzajú.
Tokenizácia je proces, pri ktorom sa text rozdeľuje na menšie jednotky (tzv. tokeny) a následne sa prevádza do číselnej podoby, ktorej model najlepšie rozumie.
Platí, že čím je tokenizácia detailnejšia, tým lepšie model chápe jazyk. Na druhej strane sa však tým zvyšuje aj výpočtová náročnosť.
Na prvý pohľad sa môže zdať, že LLM nad odpoveďou „premýšľa“. V skutočnosti však predpovedá ďalší token na základe všetkých predchádzajúcich. Ak mu napríklad napíšeš vetu „Pes stojí pri…“, model na základe pravdepodobnosti a tréningových dát určí najpravdepodobnejšie pokračovanie.
Každá odpoveď LLM je teda výsledkom štatistickej predikcie, nie vedomého rozhodovania alebo pochopenia v ľudskom zmysle slova.
Samotná architektúra by však bez rozsiahleho tréningu nestačila. Schopnosti LLM vznikajú učením na obrovskom množstve textových dát, z ktorých model odvodzuje jazykové vzorce, významy a súvislosti.
Cieľom učenia nie je zapamätať si fakty, ale naučiť sa, ako jazyk funguje a ako sa slová a vety správajú v rôznych kontextoch.
Na rozdiel od tradičných systémov založených na pevných pravidlách LLM nepracuje s presne naprogramovanými odpoveďami. Funguje na princípe pravdepodobnostných modelov, ktoré vyhodnocujú vzorce v jazyku. Dá sa to prirovnať k človeku, ktorý prečíta tisíce kníh a postupne si vytvorí cit pre jazyk, štýl a význam. Práve vďaka tomu dokáže LLM reagovať flexibilne, prispôsobovať sa rôznym témam a formulovať odpovede podľa kontextu.
Proces učenia Large Language Modelu prebieha v niekoľkých fázach, pričom každá z nich má svoj špecifický význam:
V tejto fáze model spracúva obrovské množstvo textových dát z webových stránok, článkov, kníh či konverzácií. Cieľom nie je zapamätať si konkrétne fakty, ale pochopiť vzťahy medzi slovami a vetami. Takto sa vytvára akási „mentálna mapa jazyka“, ktorá neskôr slúži na generovanie prirodzeného textu.
Počas jemného doladenia sa model trénuje na špecializovaných dátach – napríklad z oblasti práva, medicíny či technológií. Pri niektorých modeloch, ako sú GPT modely, sa využíva aj metóda RLHF (Reinforcement Learning from Human Feedback) – teda učenie s ľudskou spätnou väzbou. V praxi to znamená, že používatelia hodnotia viacero odpovedí modelu a určujú, ktorá z nich je najlepšia.
Keď je model „nasýtený“ dátami, dôležité je, aby sme sa my naučili správne formulovať otázky a inštrukcie, ktoré mu dávame. Pamätaj, že LLM nevie čítať myšlienky. Kvalita jeho odpovedí vždy závisí aj od kvality tvojho vstupu.
V praxi sa stretneš s LLM v takmer každej oblasti – od marketingu až po zdravotníctvo. Tým, že dokážu porozumieť jazyku, sú mimoriadne univerzálne a vhodné nielen na pracovné, ale aj voľnočasové využitie.
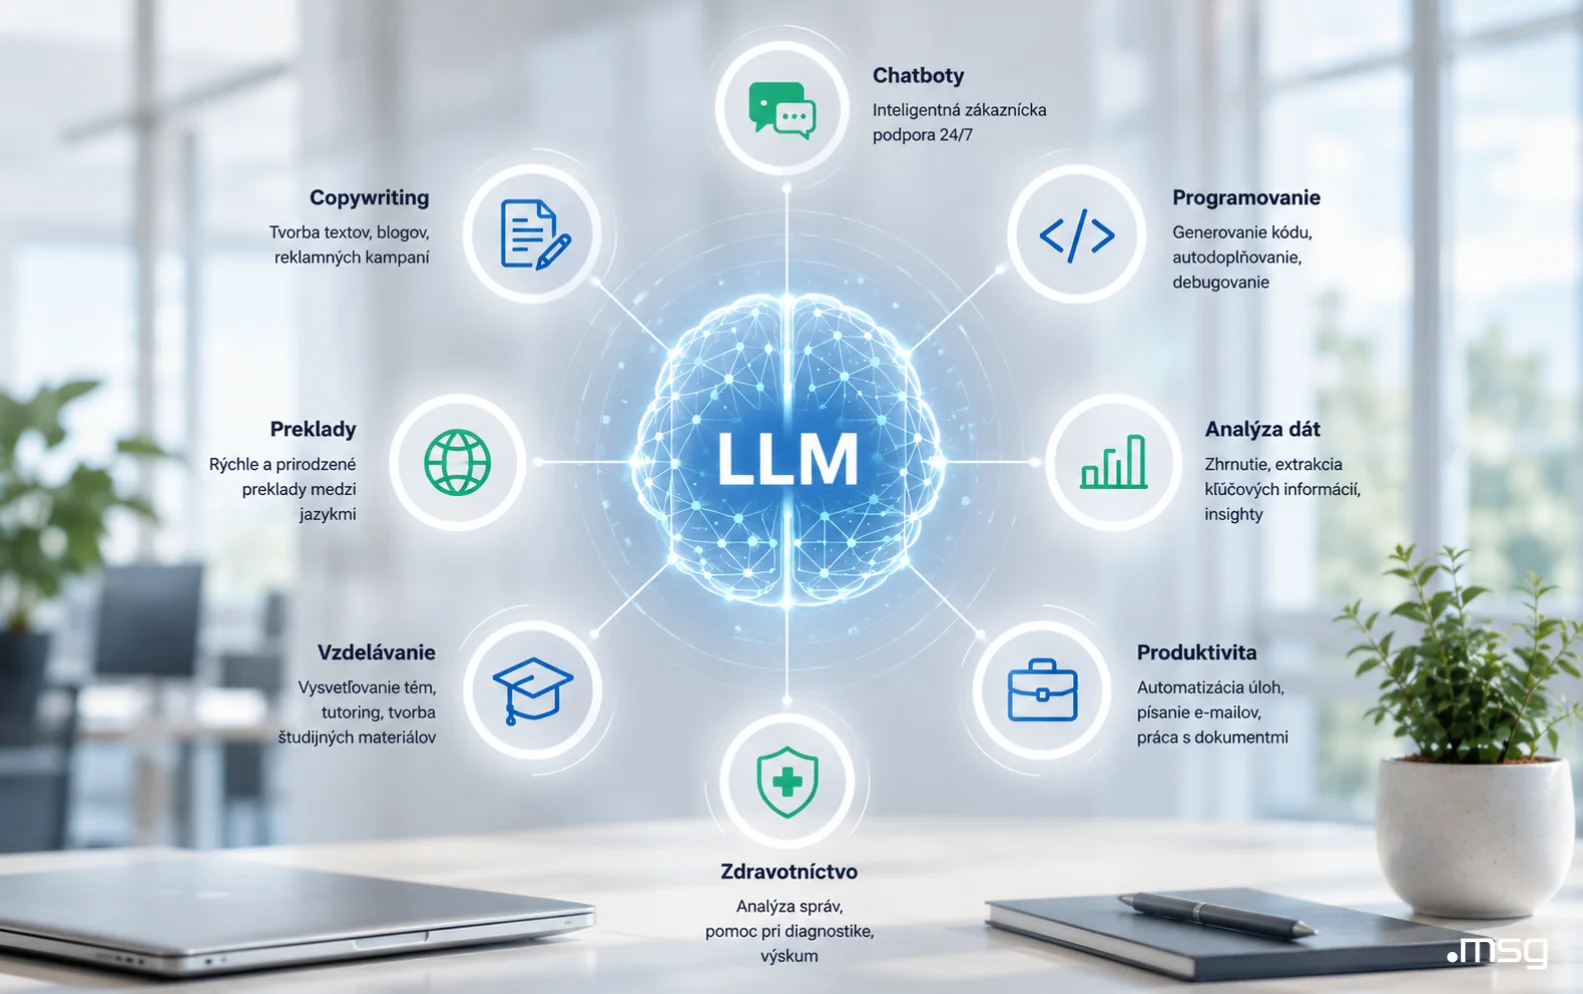
Medzi oblasti, v ktorých sa s veľkými jazykovými modelmi stretneš najčastejšie, patria:
Jedna z oblastí, kde sú LLM už bežnou súčasťou. Niet sa čomu čudovať – dokážu písať celé články, blogy, reklamné texty, produktové popisy či e-maily. Sú výborné aj na návrhy nadpisov alebo príspevkov na sociálne siete. Mnohým redakciám pomáhajú pri tvorbe súhrnov správ alebo pri skracovaní dlhých textov.
Vďaka schopnosti viesť plynulý dialóg sú LLM základom inteligentných chatbotov a virtuálnych asistentov. Firmy ich využívajú v zákazníckej podpore, kde dokážu odpovedať na bežné otázky 24 hodín denne, 7 dní v týždni.
LLM stoja aj za modernými prekladovými systémami, ktoré sú omnoho presnejšie než napríklad klasický Google Translate. Dôvodom je, že dokážu rozpoznať kontext aj kultúrne odtiene jazyka.
Veľké jazykové modely dnes pomáhajú aj programátorom. Skvelými príkladmi sú GitHub Copilot alebo ChatGPT Code Interpreter, ktoré dokážu dopĺňať kód, vysvetľovať chyby či generovať riešenia.
V súčasnosti existuje viacero veľkých jazykových modelov, ktoré sa od seba odlišujú podľa architektúry, spôsobu tréningu a účelu. Hoci všetky patria do kategórie LLM, je dobré poznať základné rozdiely medzi nimi.
Ide o najznámejšie LLM, s ktorými sa stretávajú aj bežní používatelia internetu. Prvá verzia (2018) sa učila z textov zverejnených na internete. GPT-2 už dokázal generovať súvislé texty, zatiaľ čo GPT-3 so 175 miliardami parametrov vedel písať kvalitné články, prekladať vety či dokonca programovať.
Aktuálna verzia GPT-5 (vydaná v auguste 2025) poskytuje veľmi presné odpovede, zvláda prácu s dlhým textom a výrazne znižuje halucinácie oproti predchádzajúcim modelom. Najnovšia verzia GPT-5.2 z decembra 2025 prináša ďalšie vylepšenia v oblasti kódovania a práce s dlhým kontextom.
Medzi populárne modely od Google patria Gemini a BERT. Spoločnosť zvolila mierne odlišný prístup ako OpenAI. Model BERT (z roku 2018) bol priekopníckym modelom zameraným na pochopenie významu textu. BERT využíva obojsmerný prístup, čo mu umožňuje analyzovať kontext slov z oboch strán súčasne. Na rozdiel od generatívnych modelov je BERT určený predovšetkým na analýzu a klasifikáciu textu, nie na jeho generovanie.
Gemini je novšia generácia multimodálnych modelov, pričom aktuálne verzie (Gemini 3 Pro, Gemini 3 Flash) dokážu pracovať s textom, obrázkami, zvukom aj videom.
Medzi ďalšie dôležité modely patria:
Modely LLM predstavujú revolúciu v oblasti umelej inteligencie, no zároveň prinášajú aj množstvo rizík. Medzi hlavné limity veľkých jazykových modelov patria:
LLM niekedy vytvárajú vymyslené informácie, ktoré však prezentujú ako fakty. Tento stav sa nazýva halucinácia a môže byť nebezpečný, pretože vedie k šíreniu nepravdivých údajov a hoaxov. Dôvodom je to, že modely neoverujú fakty – iba predpovedajú pravdepodobné pokračovanie textu na základe vzorcov, ktoré sa naučili. Preto si informácie z LLM vždy over z dôveryhodných zdrojov.
Každý model je len tak objektívny, ako sú objektívne jeho tréningové dáta. Ak model trénuje na textoch, ktoré obsahujú kultúrne, rodové alebo ideologické predsudky, môže ich nevedome reprodukovať. Výsledkom sú zaujaté alebo skreslené odpovede, ktoré uprednostňujú len určitú skupinu či názor.
LLM pracujú s obrovským množstvom dát, ktoré môžu obsahovať aj citlivé informácie. Tie by mohli byť v prípade zneužitia rizikové. Preto je mimoriadne dôležité, aby spoločnosti vyvíjajúce tieto modely dbali na vysokú úroveň bezpečnosti a dodržiavali zásady ochrany osobných údajov, ako je napríklad GDPR.


Large Language Model, alebo veľký jazykový model, je systém umelej inteligencie, ktorý sa učí generovať a rozumieť ľudskému jazyku. Počas tréningu spracuje obrovské množstvo textov, v rámci ktorých si všíma vzťahy medzi slovami a vetami. Takýmto spôsobom dokáže písať články, odpovedať na otázky, sumarizovať informácie a podobne.
Nie takým spôsobom ako človek. LLM totiž nemá vlastné vedomie. To, aké slovo najlepšie zapadne do vety alebo kontextu, predpovedá na základe štatistických vzorcov. Model teda presne nevie, čo slová znamenajú – dokáže len simulovať jazykové správanie.
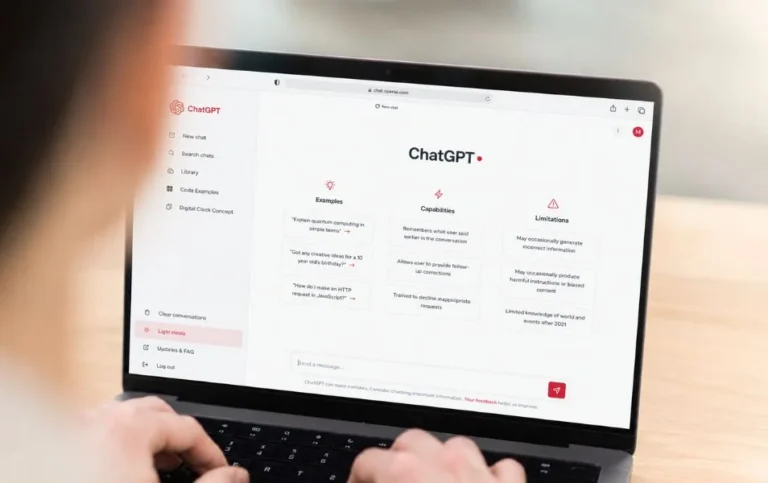
Nie úplne. ChatGPT je aplikácia, ktorá využíva LLM. Inak povedané, LLM je základný model, zatiaľ čo ChatGPT je rozhranie, ktoré ti umožňuje s ním komunikovať, vytvárať texty alebo používať iné funkcie, ktoré sú k dispozícii.
Čiastočne áno. Môžeš na to použiť open-source modely, ktoré si vieš doladiť presne podľa svojich predstáv a potrieb. Pre takéto riešenie sa najčastejšie rozhodujú väčšie firmy alebo startupy, ktoré potrebujú veľmi špecifický LLM pre svoje interné účely.
Machine learning je všeobecný pojem pre metódy, pri ktorých sa systémy učia z dát bez priameho programovania. LLM sú jednou z jeho podkategórií. Tieto modely sú známe tým, že na spracovanie prirodzeného jazyka využívajú transformátorovú architektúru.
LLM zásadne menia spôsob, akým komunikujeme s technológiami. Umožňujú počítačom porozumieť ľudskému jazyku, tvoriť obsah, prekladať, analyzovať údaje či pomáhať pri programovaní. Umelá inteligencia sa stala prirodzenou súčasťou každodenného života a výrazne nám ho uľahčuje. Napriek tomu však treba mať na pamäti, že s používaním LLM prichádza aj zodpovednosť. LLM nie je neomylný a informácie, ktoré poskytuje, je potrebné si vždy dôkladne overiť.
V msg life Slovakia sa starám o firemnú kultúru, eventy a som súčasťou marketingového tímu. Mám rada prácu, kde môžem byť kreatívna a prispieť k tomu, aby sa kolegovia v msg cítili dobre. Pravidelne pre teba pripravujem
nielen novinky a zaujímavosti zo sveta informačných technológií a poisťovníctva, ale aj zo zákulisného diania v spoločnosti msg life Slovakia.
Pozri sa, na čom spoločne pracujeme, kto sú ľudia za naším kódom a ako sme rástli. Zistíš, ako vyzerá naša práca zblízka a čo nás spája aj mimo kancelárie.